Диффузионная модель — как работает генеративная нейросеть и где применяется
Диффузионная модель — класс генеративных нейросетей: при обучении модель снимает шум с изображений, а при генерации собирает из случайного шума новую картинку по текстовому описанию.

Автор: Иван Синицин
- Опубликовано:
- 8 мин чтения
Определение
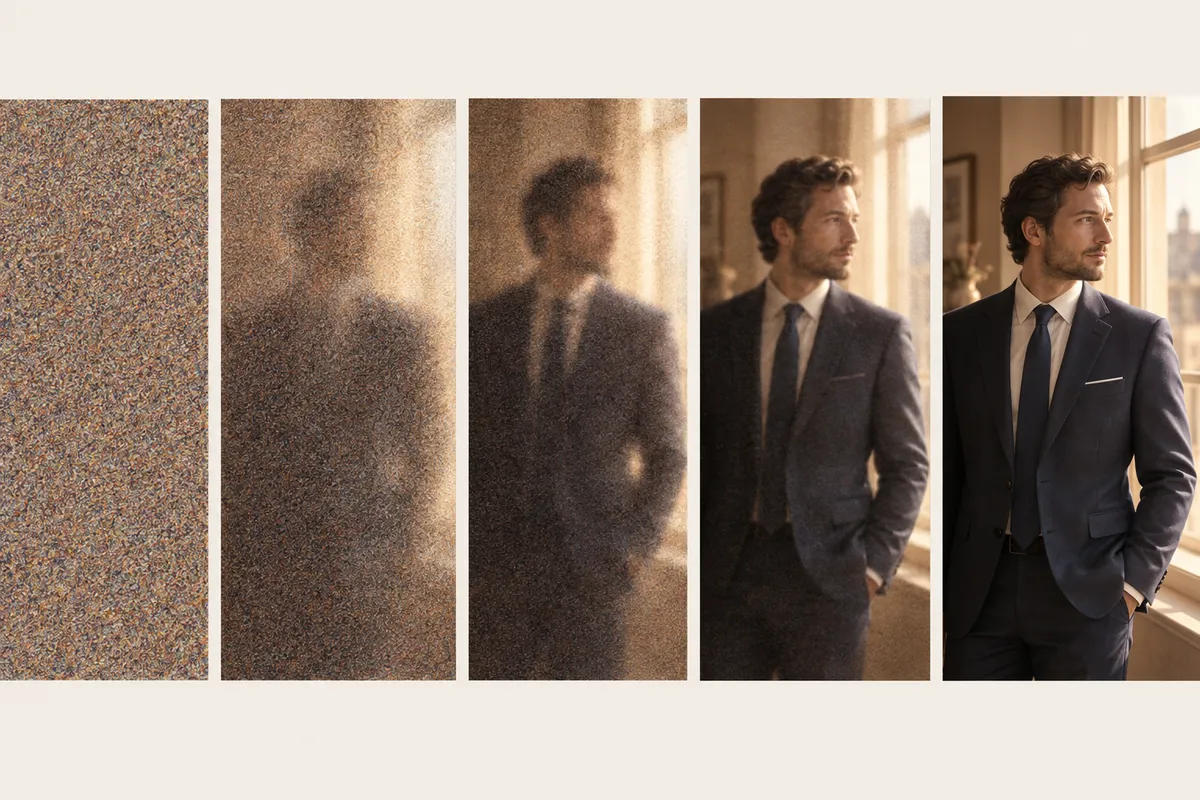
Диффузионная модель — это способ генерации, при котором нейросеть начинает с кадра, похожего на помехи старого телевизора, и за несколько десятков проходов превращает его в фотографию по вашему запросу. На каждом проходе она снимает часть ряби и сверяется с текстом: сначала проступает силуэт, потом швы и блики. Готовый снимок из базы она не подбирает, а стартовый шум всякий раз новый, поэтому два запуска одного и того же запроса дают два разных кадра.
Также называют
- диффузионные модели
- диффузионная нейросеть
- диффузионные нейросети
- модель диффузии
- diffusion model
- diffusion models
Что такое диффузионная модель простыми словами
Если коротко, это обученный шумодав, доведённый до предела. Фотографу знаком кадр, снятый на ISO 12800 в тёмном зале: зерно съедает фактуру ткани, и программа шумоподавления угадывает, где была нитка, а где складка. Диффузионной модели дают кадр, на котором от фото не осталось ничего, и короткую подсказку словами. Она решает, какой шум убрать первым, потом следующий слой, и так до чистой картинки, которой раньше не существовало.
Слово «диффузия» взято из физики. Капля туши в стакане воды растекается, пока вода не станет равномерно серой. В 2015 году исследователи предложили учить нейросеть обратному ходу — собирать «каплю» из равномерной мути. Практичной для картинок идея стала в 2020 году, после работы о моделях DDPM.
Диффузионные модели — одна из семей генеративного ИИ рядом с генеративно-состязательными сетями (GAN) и авторегрессионными моделями. Генеративными их называют потому, что они создают новое изображение, а не ищут готовое.
Как устроена диффузия: шум, шаги и латентное пространство
Работа делится на две фазы: обучение, где модель учится угадывать шум, и генерацию, где она этот шум убирает. Качество кадра зависит ещё от трёх деталей — шагов, латентного пространства и текстового энкодера.
Обучение: угадать, какой шум добавили
Модели показывают миллионы снимков с подписями и к каждому подмешивают шум случайной силы, от лёгкого зерна до сплошной ряби. Задача одна: предсказать, какой именно шум добавлен. Так нейросеть усваивает не сами фотографии, а закономерности: где у пиджака проходит линия лацкана, как ворс шерсти бликует в контровом свете. Подписи учат связывать эти закономерности со словами.
Генерация: от ряби к кадру по шагам
Генерация стартует с чистого шума, который задаёт случайное число — seed. На каждом шаге диффузионная модель оценивает шум в текущем кадре и убирает его часть. Первые шаги решают композицию и силуэт, средние — формы: лацканы, складки, черты лица. Последние — фактуру и мелочи вроде строчки на кармане.
У классических версий шагов обычно 20–50, у ускоренных (дистиллированных) — от 1 до 8. Тот же seed с тем же промтом и настройками, как правило, повторяет кадр, новый seed даёт другой вариант сцены.
Латентное пространство
Большинство современных моделей очищают не пиксели, а сжатое описание кадра — латентное пространство. У Stable Diffusion 1.x кадр 512×512 пикселей превращается в сетку 64×64 с четырьмя каналами: чисел в 48 раз меньше. Декодер в конце разворачивает сетку в фотографию. Так быстрее и легче для видеокарты, но палец или буква на бирке занимают считаные клетки.
Текстовый энкодер
Промт модель напрямую не читает. Текстовый энкодер превращает его в набор векторов: у Stable Diffusion 1.x это CLIP, у Imagen — T5. На каждом шаге модель сверяется с ними через механизм внимания. Силу сверки задаёт guidance scale: на низких значениях модель отвлекается от запроса, на слишком высоких цвета перенасыщаются, а кожа выглядит пластиковой.
Чем диффузия отличается от GAN
Главное отличие — в числе проходов. GAN рисует кадр за один проход сети, диффузия — за десятки шагов. GAN быстрее, диффузия разнообразнее и точнее следует тексту.
| GAN | Диффузионная модель | |
|---|---|---|
| Как учится | генератор соревнуется с дискриминатором, который ловит подделки | учится предсказывать и убирать шум |
| Как создаёт кадр | за один проход | за 20–50 шагов, ускоренные версии — за 1–8 |
| Устойчивость обучения | капризная: генератор может зациклиться на нескольких удачных вариантах | ровнее, без поединка двух сетей |
| Широта тем | сильна в узкой теме, например в портретах | любые сюжеты из обучающих данных |
| Управление текстом | ограниченное | основной режим работы |
В 2021 году исследователи OpenAI в работе «Diffusion Models Beat GANs on Image Synthesis» показали, что диффузия обходит лучшие GAN по качеству. С тех пор генерация по тексту в основном держится на диффузионных моделях и их родственниках: Stable Diffusion 3 и FLUX построены на выпрямленном потоке (rectified flow) — разновидности согласования потоков, где путь от шума к картинке спрямлён.
GAN при этом не исчезли: их приём с дискриминатором ускоряет диффузию. SDXL Turbo обучали с состязательной функцией потерь, и он выдаёт кадр за 1–4 шага.
Где применяются диффузионные модели: от генерации до примерки
Почти везде, где нейросеть рисует или дорисовывает изображение. Один механизм очистки шума работает в нескольких режимах:
- Текст в изображение. Кадр с нуля по описанию: сцена, свет, одежда, ракурс.
- Изображение в изображение. Модель частично зашумляет ваше фото и очищает заново. Параметр denoising strength решает, сколько останется от исходника: на малых значениях сохраняются поза и композиция, на больших — только общая раскладка цветов.
- Дорисовка по маске. Инпейнтинг заполняет шумом только выделенную область — рукав, пятно на фоне, вещь на человеке — и очищает её с оглядкой на остальной кадр. Аутпейнтинг так же расширяет холст: квадратный кадр становится вертикальным 3:4 под карточку товара.
- Увеличение разрешения. Диффузионные апскейлеры не растягивают пиксели, а дорисовывают детали и могут выдумать фактуру, которой на исходнике не было.
- Видео. OpenAI описывала Sora как диффузионную модель, которая очищает от шума сразу последовательность кадров.
В моде самое заметное применение — виртуальная примерка. В 2023 году исследователи Google описали TryOnDiffusion: диффузионная модель переносит вещь со снимка товара на человека с другого фото и подстраивает её под позу. Ту же задачу решает примерка одежды по фото: вещь из каталога, ваш снимок вещи или ссылка с Wildberries и ЦУМа — на вашем фото, готовой нейромодели или параметрической модели по росту, весу и обхватам. Это визуализация силуэта, цвета и длины, а не замер посадки: размер выбирают по размерной сетке.
Что зависит от вас, когда нейросеть генерирует портрет
Сервисы ИИ-фотосессий работают на генеративных моделях изображений — диффузионных или родственных им; разработчики крупных моделей не всегда раскрывают архитектуру. Пользователю важнее другое: у генерации три условия, и каждым из них вы управляете.
- Фото — источник внешности. С него модель берёт черты лица, причёску, телосложение. Чем меньше ей приходится додумывать, тем ближе результат: лицо крупно и в фокусе, ровный рассеянный свет у окна, без бьюти-фильтров и тёмных очков. Селфи на вытянутой руке искажает пропорции, и модель примет искажение за вашу форму лица.
- Промт — сцена, свет, одежда, обработка. В ИИ-фотосессии по фото сцену, свет и обработку задаёт выбранный стиль, их десятки: деловой портрет для резюме и сайта компании, арт-портрет, ретро, праздничная серия. Вы выбираете стиль и загружаете снимок.
- Разрешение — до генерации. Кадр создаётся сразу в выбранном размере: 1K, 2K или 4K. Для аватара хватает 1K, для печати берите 4K.
Делайте несколько вариантов: каждый запуск начинается с нового шума, и кадры отличаются, как дубли на настоящей съёмке.
Деловой портрет сверьте с обычным своим снимком. Модель тянется к пропорциям, которые чаще встречались в обучающих снимках, и может «усреднить» линию плеч, шею и посадку пиджака. Плечи заметно шире или уже ваших — запустите ещё вариант. Фон и кадрирование для делового снимка разобраны в статье про фото на резюме.
Почему диффузия ошибается в руках и тексте
Модель воспроизводит статистику, а не правила: она знает, как обычно выглядит рука или надпись, но не считает пальцы и не знает алфавита. К тому же мелкие детали занимают в латентной сетке слишком мало места.
Руки
Кисть на снимках почти всегда частично закрыта: пальцы в кармане, на ручке сумки, переплетены. Из миллионов таких поз модель выводит усреднённое «что-то похожее на руку». В кадре в рост кисть занимает малую долю площади, в сжатой сетке это считаные клетки, и пятый палец срастается с четвёртым или рядом появляется шестой.
Текст и логотипы
Текстовый энкодер видит промт как токены — куски слов, а не буквы. Буква же — точная форма, где ошибка в одном штрихе сразу заметна. Поэтому надпись на футболке или бирка часто выходят набором похожих на буквы знаков. Новые модели пишут заметно лучше, но длинный текст и кириллица по-прежнему подводят.
Что ещё проверять на готовом кадре
- узор ткани: клетка и полоска «плывут» на складках;
- парные детали: серьги, манжеты, число пуговиц;
- фурнитуру: молния уходит в никуда, пряжка теряет язычок;
- посадку: диффузионная модель не знает свойств ткани и ваших мерок, вещь садится так, как обычно садятся похожие вещи.
Всё это частные случаи галлюцинаций нейросети, когда модель уверенно выдаёт правдоподобное, но неверное. Перед публикацией смотрите кадр в масштабе 100%: руки, надписи, застёжки.
Связанные понятия
- Генеративный ИИ — общий класс моделей, диффузия — одна из его архитектур.
- Stable Diffusion — латентная диффузионная модель с открытыми весами.
- LoRA — лёгкое дообучение модели на небольшом наборе снимков: лицо, стиль, вещь.
- Инпейнтинг и аутпейнтинг — дорисовка внутри маски и за краем кадра.
- Virtual try-on — примерка вещи на фото человека.
Если запомнить одно: диффузионная модель не ищет готовые снимки в базе, а каждый раз заново собирает кадр из шума по вашим условиям. Поэтому от исходного фото и точности описания зависит, насколько кадр выйдет похожим и чистым.
Связанные термины
Генеративный ИИ
Генеративный ИИ — класс нейросетей, которые создают новый текст, изображения, звук или видео по запросу, опираясь на закономерности, выученные на больших наборах данных.
Инпейнтинг
Инпейнтинг (inpainting) — перерисовка выделенной маской области изображения: нейросеть заполняет её новым содержимым, согласуя свет, фактуру и перспективу с остальным кадром.
Галлюцинации нейросети
Галлюцинации нейросети — уверенный, но неверный результат ИИ: выдуманные факты и источники в тексте, лишние пальцы, кракозябры и несуществующие детали на картинке.
LoRA
LoRA (Low-Rank Adaptation) — метод дообучения нейросети небольшой надстройкой: модель учат новому стилю, персонажу или вещи, а её исходные веса оставляют без изменений.
Virtual try-on
Virtual try-on (VTO) — технология, которая показывает товар на изображении человека: помаду, цвет волос, очки или вещь на фото. Это визуализация, а не замер размера.
Апскейл фото
Апскейл фото — увеличение разрешения снимка с досчётом недостающих пикселей: интерполяцией по соседним точкам или нейросетью, которая дорисовывает детали по обученной модели.
FAQ
Вопросы и ответы
Что такое диффузионная модель простыми словами?
Это нейросеть, которая рисует картинку, убирая шум. Представьте снимок, на котором вместо изображения сплошная серая рябь, как на экране телевизора без сигнала. Диффузионная модель смотрит на эту рябь и решает, какую её часть убрать, чтобы проступило то, что вы описали словами, например «мужчина в тёмно-синем костюме у окна, мягкий дневной свет». За один шаг она снимает немного шума, за десятки шагов — весь, и в конце остаётся готовая фотография. Учится такая модель на миллионах снимков с подписями: к каждому подмешивают шум и просят угадать, какой именно добавлен. Так она запоминает не сами фото, а закономерности: как выглядят ткань, лицо, свет из окна. Поэтому кадр почти всегда получается новым. Полной гарантии нет: исследователи показывали, что модель изредка воспроизводит почти копию снимка, который много раз повторялся в обучающих данных. На этом принципе построены Stable Diffusion первых поколений, DALL·E 2 и 3, Imagen, Kandinsky 2 и 3, а также инструменты, которые дорисовывают или заменяют фрагмент фотографии.
Как работает диффузионная модель?
Генерация идёт в четыре этапа. Сначала текстовый энкодер, отдельная нейросеть вроде CLIP или T5, превращает промт в числовые векторы, понятные модели. Затем программа создаёт стартовый шум — случайную сетку чисел, которую задаёт seed. У большинства современных моделей это не пиксели, а сжатое латентное представление кадра, так работа идёт быстрее. Третий этап основной: модель раз за разом оценивает, какой шум лежит в текущей сетке, и убирает его часть, сверяясь с векторами промта. На первых шагах появляется композиция, на последних — фактура ткани и блики. Классическим моделям нужно 20–50 таких шагов, ускоренным — от 1 до 8. На последнем этапе декодер разворачивает очищенную сетку в обычное изображение нужного размера. Если оставить тот же seed, промт и настройки, кадр, как правило, повторится. Если сменить seed, получится другой вариант той же сцены, поэтому повторный запуск и даёт новый кадр: очистка стартует с другого шума.
Что является основной идеей работы диффузионных моделей?
Основная идея — научить нейросеть обращать вспять постепенное разрушение. Возьмите любую фотографию и добавляйте к ней понемногу шум: через сотни мелких шагов (в работе DDPM их была тысяча) от снимка останется равномерная рябь. Этот прямой процесс прост и обучения не требует. Обратный — восстановить снимок из ряби — сложен, и именно его поручают нейросети. Хитрость в том, что каждый отдельный шаг маленький: модели не нужно сразу угадать всю картинку, достаточно понять, как немного очистить текущее состояние. Идею в 2015 году предложили исследователи из Стэнфорда и Беркли, вдохновившись неравновесной термодинамикой, отсюда и слово «диффузия». Практичной она стала в 2020 году после работы Denoising Diffusion Probabilistic Models (DDPM) Джонатана Хо и соавторов: там модель училась предсказывать добавленный шум. Текстовые подсказки, латентное пространство и ускоренные режимы с малым числом шагов появились позже, но фундамент остался прежним: разрушить легко, а нейросеть учат собирать обратно шаг за шагом.
Что такое генеративные диффузионные модели?
Это те же диффузионные модели, просто с уточнением класса. Генеративными называют нейросети, которые создают новые данные, а не распознают или сортируют существующие. Модель поиска похожих товаров по фото отвечает на вопрос «что это», генеративная выдаёт новый объект: картинку, текст, звук. Диффузия — один из способов генерации наряду с GAN, авторегрессионными моделями и согласованием потоков (flow matching). Её отличает путь через шум: результат не складывается из готовых кусочков, а проявляется из случайной ряби. Отсюда два практических следствия. Первое: одна и та же модель нарисует что угодно, от пэкшота кроссовка до портрета в манере масляной живописи, если похожее было в обучающих данных. Второе: результат вероятностный. Два запуска с одинаковым промтом дают разные кадры, а мелкие детали вроде пальцев, надписей и пуговиц иногда выходят неправдоподобными. Для съёмки одежды это значит, что генерацию проверяют так же придирчиво, как работу ретушёра: в полном масштабе и по исходнику вещи.
Какие нейросети построены на диффузионной модели?
Из генераторов изображений на диффузии построены Stable Diffusion версий 1.x, 2.x и SDXL (латентная диффузия), DALL·E 2 и DALL·E 3 от OpenAI, Imagen от Google и Kandinsky 2 и 3 от Сбера. Следующее поколение часто опирается на родственный подход — согласование потоков (flow matching), в том числе его вариант с выпрямленным потоком (rectified flow): так устроены Stable Diffusion 3, FLUX и Kandinsky 5. Диффузия работает и в видео: OpenAI описывала Sora как диффузионную модель. Часть крупных сервисов архитектуру полностью не раскрывает, поэтому фраза «нейросеть рисует картинки» ещё не означает «диффузионная». Кроме генераторов, диффузию используют в инструментах дорисовки по маске, расширения кадра и увеличения разрешения, а также в исследованиях виртуальной примерки, например в работе Google TryOnDiffusion 2023 года. Если хотите увидеть механику своими глазами, самая доступная точка входа — Stable Diffusion в интерфейсах Automatic1111, Forge или ComfyUI. Там на виду все параметры, о которых идёт речь: число шагов, seed, guidance scale и denoising strength, и можно проверить, как каждый из них меняет кадр.
Что такое текстовые диффузионные модели?
Под этим запросом обычно имеют в виду одно из двух. Чаще — диффузионные модели, управляемые текстом (text-to-image): вы пишете описание, модель по нему собирает картинку. Текст в них не генерируется, он служит условием. Отдельный текстовый энкодер переводит промт в векторы, и на каждом шаге очистки шума модель сверяется с ними через механизм внимания. Силу этой сверки задаёт параметр guidance scale: на низких значениях модель следует запросу слабо, на очень высоких кадр становится перенасыщенным и жёстким. Второе значение — модели, которые диффузией создают сам текст; их называют диффузионными языковыми моделями. Для фотосессии нейросетью важно первое: качество текстового условия решает, насколько кадр совпадёт с замыслом. Конкретика работает лучше оценок: «тёмно-синий шерстяной пиджак, белая рубашка, мягкий свет слева» даёт модели больше опоры, чем «красивый деловой образ». Описывайте вещь так, как описали бы её ассистенту на съёмке: цвет, материал, фасон, свет.
Что такое диффузионная языковая модель?
Это языковая модель, которая пишет текст не слово за словом, как привычные чат-боты, а уточняет весь ответ сразу. Обычная большая языковая модель авторегрессионная: она предсказывает следующий фрагмент, дописывает его и переходит к следующему, поэтому длинный ответ появляется постепенно. Диффузионная языковая модель стартует с черновика, где все позиции скрыты или «зашумлены», и за несколько проходов делает их осмысленными, причём может поправить уже написанное в начале. В мае 2025 года Google DeepMind показала экспериментальную модель Gemini Diffusion, и главным её плюсом в анонсе называли скорость генерации. В генерации картинок диффузия вышла на первый план в 2022 году, с DALL·E 2, Imagen и Stable Diffusion, в тексте она пока во многом остаётся исследовательской областью и догоняет авторегрессионные модели. Для тех, кто работает с фото одежды, это скорее новость индустрии: генерация изображений в ИИ-фотосессии и примерке опирается на модели изображений, а не на текстовую диффузию.
Что такое латентная диффузионная модель?
Это диффузионная модель, которая очищает от шума не саму картинку, а её сжатое представление — латентное пространство. Работу Робина Ромбаха и соавторов о таких моделях представили на конференции CVPR в 2022 году, и подход лёг в основу Stable Diffusion. Схема из трёх частей. Кодировщик, вариационный автокодировщик (VAE), сжимает изображение: у Stable Diffusion 1.x каждая сторона кадра уменьшается в восемь раз, а три цветовых канала заменяются четырьмя латентными. Диффузионная часть работает с этой сжатой сеткой, и каждая её клетка отвечает за квадрат 8×8 пикселей. Декодер в конце разворачивает результат обратно в фотографию. Выигрыш — скорость и память: такие модели запускаются на домашних видеокартах. Цена — потеря мелочей. Ресница, буква на бирке, кончик пальца занимают в сетке долю клетки, и декодеру приходится их достраивать. Поэтому на латентных моделях чаще встречаются поплывшие надписи и пальцы, а лицо или руку при инпейнтинге перерисовывают на увеличенном фрагменте: так деталь получает больше клеток сетки.

Автор материала
Иван Синицин
Стилист, блогер, автор статей
Иван Синицин пишет для AI Dressup о стиле и гардеробе: как собрать капсулу из вещей, которые уже висят в шкафу, подобрать цвета под свою внешность и одеться по дресс-коду без лишних покупок. Отдельная тема его материалов — как проверить образ до покупки с помощью ИИ-примерки и ИИ-стилиста и где у такой визуализации границы.
Все материалы автораЧитайте также
Как позировать на фото: позы стоя и сидя, руки, ракурс и выражение лица
Позирование на фото — это не талант, а набор настроек тела: вес на одной ноге, корпус вполоборота, занятые руки, подбородок вперёд-вниз и камера на нужной высоте.
Фото на резюме: требования, удачные примеры и съёмка без студии
Фото на резюме — деловой портрет, по которому работодатель составляет первое впечатление: лицо хорошо видно, фон спокойный, взгляд в камеру, одежда уместна для профессии.
Лукбук: что это такое и как бренду одежды сделать лукбук без студии
Что такое лукбук в моде, чем он отличается от каталога, пэкшота и кампейна и как малому бренду одежды собрать серию образов за пять шагов — от мудборда до вёрстки, в том числе на ИИ-моделях.


